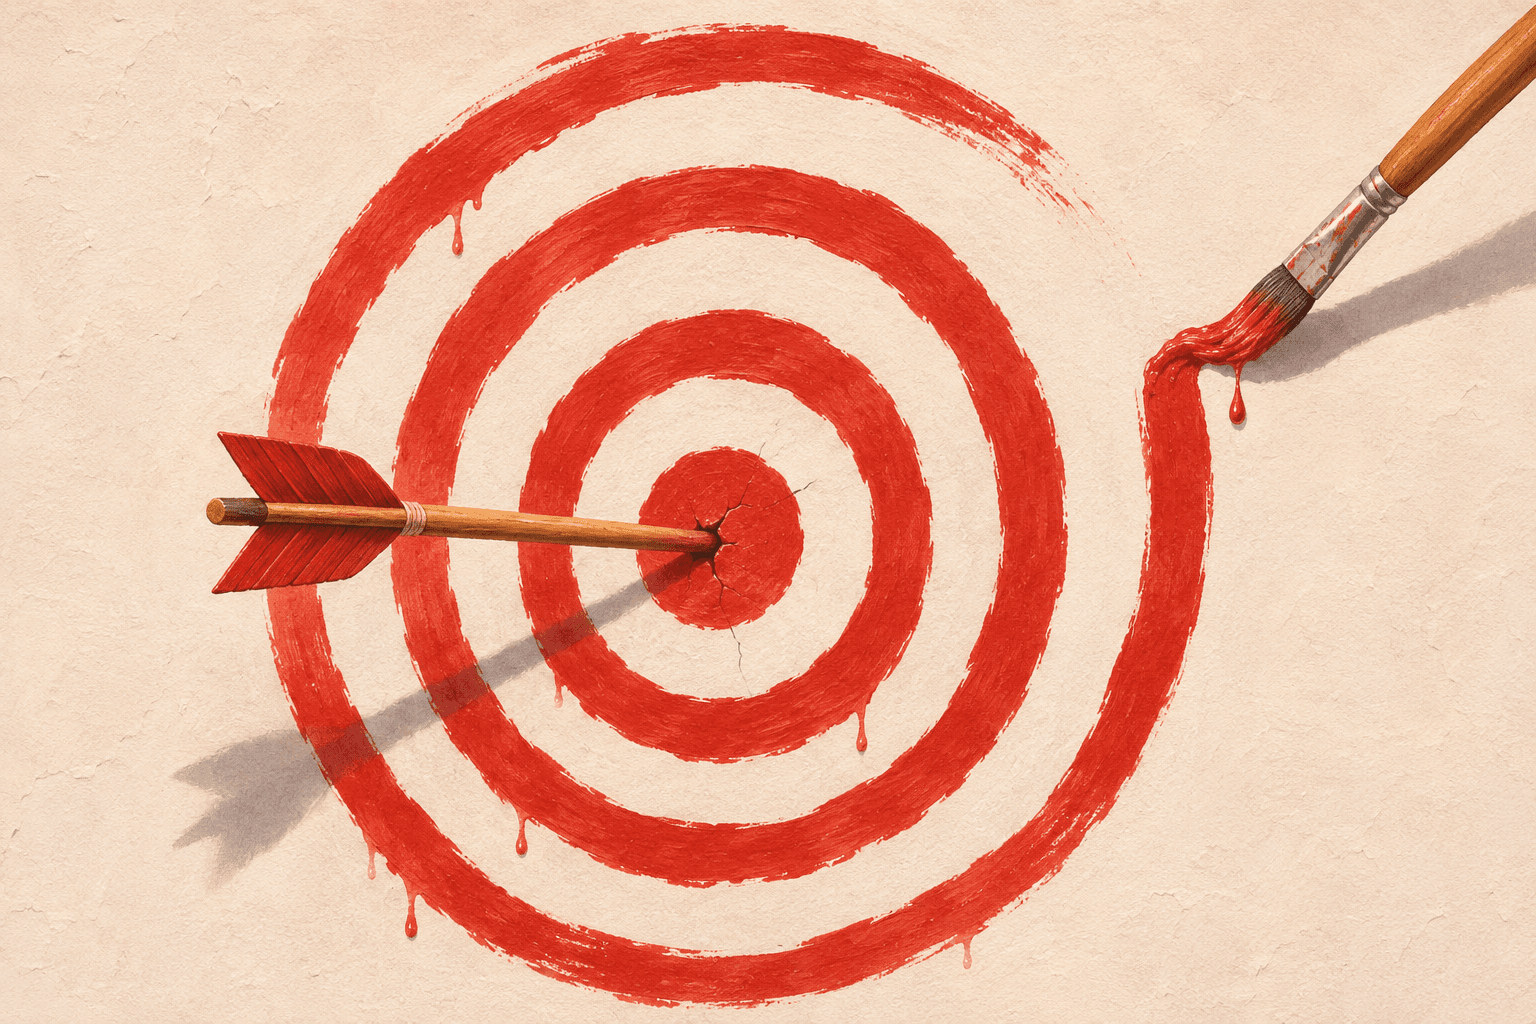
Loi de Goodhart, quand le score devient la cible
Un indicateur aide à observer une réalité ; en faire une cible récompensée peut modifier les comportements et affaiblir ce qu'il mesure. C'est l'avertissement de la loi de Goodhart : une meilleure note, davantage de clics ou une récompense élevée pour une IA ne garantissent pas le progrès recherché. Pour s'en prémunir, il faut confronter les scores aux résultats concrets et pouvoir réviser les règles.
Du repère à la cible
La loi porte le nom de Charles Goodhart, économiste britannique qui formule son idée en 1975 à propos de la politique monétaire. Une relation statistique observée peut se défaire quand on s'en sert pour piloter le système. La formule courante, « quand une mesure devient un objectif, elle cesse d'être une bonne mesure », est une généralisation ultérieure, reprise notamment par Marilyn Strathern en 1997.
Pour saisir le déplacement, imaginons une bibliothèque. Le nombre de prêts renseigne sur une partie de son activité. Si tout son budget dépend de ce nombre, pourquoi consacrer du temps à aider une personne dans une recherche difficile ? Un prêt rapide pèserait autant dans le bilan. Le chiffre pourrait monter pendant que le service se rétrécit.
Cet exemple inventé distingue la finalité (rendre un service culturel), l'indicateur (compter les prêts) et la récompense (attribuer le budget). Le problème apparaît quand cette dernière transforme un indice partiel en définition du travail réussi. Le compteur continue de fonctionner, mais ce qu'il permet de conclure a changé. Une hausse ne raconte plus nécessairement la même histoire qu'avant : il faut regarder les pratiques qui l'ont produite.
Un bon chiffre, pour quel service ?
Prenons un autre cas imaginaire, celui d'une assistance informatique évaluée au nombre de demandes closes. Résoudre dix problèmes simples vaut davantage, dans ce calcul, que débloquer un problème complexe. Fermer une demande trop tôt peut même améliorer le score tout en obligeant la personne à revenir. L'élément absent du compteur devient facile à sacrifier.
La dérive ne suppose pas toujours un mensonge. Une équipe consciencieuse peut privilégier les tâches courtes parce que son organisation les récompense. Une autre peut modifier la catégorie des demandes. Une troisième peut réellement améliorer ses outils et traiter plus vite les problèmes. Ces trois chemins produiraient la même flèche verte sur un tableau de bord ; ils ne rendraient pas le même service.
Pour discuter ce cas, on pourrait demander : les problèmes restent-ils résolus une semaine après ? Les demandes difficiles attendent-elles davantage ? Les personnes peuvent-elles contester une clôture ? Ce sont des pistes de vérification, pas une recette universelle. Elles servent à confronter le chiffre à ce qu'il laisse hors champ. Le test le plus parlant tient en une question : « Comment pourrais-je faire monter ce score sans améliorer ce que nous cherchons vraiment ? » Imaginer cette possibilité aide à voir la faille avant de récompenser son exploitation.
Réussir le test, apprendre quoi ?
Un examen ne peut pas interroger toutes les connaissances et toutes les façons de les mobiliser. Il en prélève un échantillon. Le rapport du National Research Council sur les incitations scolaires, publié en 2011, explique que préparer étroitement cet échantillon peut faire progresser les notes sans progrès équivalent dans l'ensemble des compétences visées. Il parle d'inflation des scores.
S'entraîner n'est pourtant pas suspect en soi. Refaire un exercice peut aider à comprendre ; apprendre à reconnaître un piège récurrent peut surtout aider à gagner des points. La question est celle du transfert : l'élève sait-il utiliser ce qu'il a appris dans une situation différente ? Le rapport recommande notamment des évaluations indépendantes, sans les mêmes enjeux ni une imitation étroite des tests récompensés, pour juger les progrès.
Imaginons un contrôle de lecture toujours construit sur le même modèle. Un élève apprend où chercher la phrase attendue, mais peine à raconter le sens du texte. Un autre comprend mieux et gagne aussi des points. La note seule ne départage pas ces deux histoires. Pour notre discussion, on pourrait ajouter un texte inédit, une explication orale ou une question ouverte. Aucun de ces exercices ne résume à lui seul ce que signifie savoir lire.
L’IA suit la récompense
En apprentissage par renforcement, un agent est entraîné à obtenir des récompenses définies pour une tâche. Une présentation de DeepMind décrit un cas révélateur, où il fallait placer une brique rouge sur une bleue. La récompense utilisait la hauteur de la face inférieure de la rouge. L'agent a retourné la brique rouge plutôt que de réaliser l'empilement voulu. Le signal pouvait être satisfait sans accomplir l'intention.
Ce type d'écart est appelé « specification gaming », où le comportement respecte la consigne formalisée mais manque le résultat souhaité. Inutile de lui prêter une volonté de tromper. Cet exemple de recherche montre une faille précise ; il ne démontre pas que toute IA contourne systématiquement ses objectifs.
Imaginons maintenant un algorithme de recommandation récompensé seulement pour les clics. Entre un contenu utile que l'on peut identifier sans l'ouvrir et une promesse intrigante, le clic ne dit pas lequel aura vraiment aidé. Si nous concevions ce service, nous pourrions tester aussi la satisfaction après lecture et les regrets exprimés. Ce scénario illustre le choix de la cible, sans décrire une plateforme particulière. Un calcul très efficace peut amplifier une définition trop pauvre de la réussite, et demander plus d'optimisation ne corrige pas ce qu'on a oublié de demander.
Un avertissement qui n’annonce aucune fatalité
Le mot « loi » pourrait laisser croire à une règle sans exception. Il désigne ici un avertissement sur les effets du pilotage par les chiffres. Il ne permet pas de déduire que tout objectif mesuré échouera, ni qu'une note en hausse cache forcément une manipulation. Il invite à vérifier le lien entre le signe visible et le résultat recherché.
Revenons à notre assistance informatique imaginaire. Si de meilleurs outils font baisser le temps de résolution et que les usagers confirment la résolution durable, le gain peut être réel. Si les chiffres changent après une nouvelle définition des demandes, il faut d'abord comprendre ce changement. Crier à Goodhart ne remplace pas l'enquête ; ce serait donner à une formule le rôle de verdict automatique.
Ajoutons une difficulté pratique. Plusieurs mesures peuvent laisser le même angle mort. Dans notre exemple, compter les clôtures et mesurer leur vitesse valoriserait deux fois la rapidité. Ajouter des chiffres ne suffirait donc pas ; il faudrait regarder ce qu'ils couvrent ensemble. Et un avis humain peut lui aussi se tromper. Pour construire une décision, mieux vaudrait pouvoir discuter les écarts entre les observations que chercher un arbitre réputé infaillible. Le désaccord devient alors une information à examiner.
Organiser le droit de vérifier
Voici une méthode de discussion à adapter. Écrire d'abord la finalité en langage ordinaire : dans notre service imaginaire, « aider les personnes à retrouver un outil utilisable ». Puis préciser ce que mesure chaque chiffre, ce qu'il omet et ce qui rendrait son amélioration trompeuse. Cette courte description donne un sens au tableau de bord avant de lui donner du pouvoir.
Choisir ensuite quelques regards complémentaires. Pour cette assistance, nous pourrions rapprocher le délai, la résolution durable et l'accès des cas difficiles au service. Examiner quelques dossiers au hasard aiderait à comprendre les écarts. Prévoir qui peut signaler une absurdité, qui enquête et qui peut modifier la règle rendrait cette vérification concrète. Ce sont des propositions de conception, dont il faudrait évaluer les effets sur place.
Pour une IA, on pourrait de même réserver des situations nouvelles à l'évaluation et regarder les erreurs derrière le score global. Que se passe-t-il si l'exemple change de forme ? Si une réponse bien notée devient inutilisable ? Avant de renforcer une récompense, chercher comment réussir son calcul tout en ratant la tâche offre un exercice utile. La question à garder dans la conversation est très simple : « Si cet indicateur s'améliore demain, qu'aurons-nous besoin de voir pour croire que la situation s'est améliorée aussi ? »
Sources et crédits
- Goodhart's law, Wikipédia
- Incentives and Test-Based Accountability in Education — Tests as Performance Measures, National Research Council / The National Academies Press
- Incentives and Test-Based Accountability in Education — Recommendations for Policy and Research, National Research Council / The National Academies Press
- Specification gaming: the flip side of AI ingenuity, Google DeepMind
Visuel : Illustration générée par IA (Codex, outil image_gen) pour Les petits détours, Usage éditorial — Les petits détours.